
Terra 能解决什么问题
GPT-6.1 Terra 的核心是快速视觉推理与精准计算机操作:理解屏幕或图纸,再在软件中执行任务。清晰写作与增强的编程能力为这一工作流提供支持。它强调日常任务的执行效率与成本,最复杂的编程和研究仍应优先考虑 Sol 或 Astra。
当前 QVeris 测试目录已列出 Terra,支持文本、图像输入与文本输出;本页双模型体验先开放纯文本问题,不调用外部工具。左侧默认 Terra,两侧均可从本文介绍的模型中选择不同型号。
OpenAI 文档给出的上下文为 1,050,000 token、最大输出为 128,000 token;工具调用需要 Responses API。本页采用直接回答模式,关闭深度思考;为控制试用成本,每个回答最多生成 1,024 个输出 token,因此不适合要求一次返回超长完整报告的任务。
四款模型:能力与使用边界
先看任务,再看接入方式。下表区分厂商公布的模型能力、建议先试的工作,以及当前 QVeris 路由与本页实际提供的功能。试用建议是本文的选型建议,不是新增跑分。
| 模型 | 官方能力与依据 | 建议先试的任务 | 接入与页面边界 |
|---|---|---|---|
| GPT-6.1 Terra | 视觉推理、屏幕操作与清晰写作;发布稿同时报告了相对 5.6 Terra 的终端编程提升。 发布稿 | 读取发票字段、解读图纸、检查小函数,或把材料整理成方案。 | 官方工具调用要求 Responses API;测试目录未给此路由标注 tools。本页仅做文本问答,不操作电脑。 |
| GPT-5.6 Terra | 5.6 系列中面向日常工作的均衡型号,可作为迁移对照。发布稿里 Sol 的分数不能套给 Terra。 发布稿 | 复用现有提示词,比较字段准确性、人工修改量及总费用,再决定是否迁移。 | 上下文相同不代表能力相同;应将旧版作为基线,用相同任务验证差异。 |
| Qwen 3.7 Plus | 官方型号说明强调网页开发、生成物、OCR 与空间理解,支持文本、图片、视频输入。 型号说明 | 可先试结构化提取、中文材料整理与前端需求说明,结合下方价格表作为低单价文本对照。 | 此 QVeris 路由列出文本、图片,未列视频。不能使用 Qwen3.7-Max、3.8-Max 的跑分替代 Plus;本页不提供图片、视频上传。 |
| Kimi K3 | 发布稿面向长程编程与知识工作,涉及大型仓库、终端工具及原生视觉。 技术发布稿 | 适合先评估多文件修改规划、长文档综合与工程方案解释,并设置明确验收条件。 | 当前 QVeris 路由仅列文本输入。厂商演示依赖 Agent 环境;K3 Cluster、K3.1 Pro 不能与本页 K3 混为同一配置或型号。 |
从原始发布材料看具体差异
| OpenAI 报告的评测 | GPT-6.1 Terra | GPT-5.6 Terra | 条件与含义 |
|---|---|---|---|
| Terminal-Bench 4.0 | 50.3% | 21.5% | 最高推理设置;终端编程任务。公布分数相差 28.8 个百分点,属于厂商报告的对比。 |
| 内部事实错误测试 | 16.7% | 53.6% | 低推理设置;越低越好。对应内部诱错提示词集合,不代表所有业务中的幻觉率。 |
OpenAI 用发票录入账务、图纸转 3D 等工作流说明从视觉理解到操作的能力;Moonshot 报告了 MiniTriton 编译器开发,以及最多 24 小时完成四项 GPU 内核优化任务的案例。可查看 Terra 发布稿 与 K3 技术博客 中的原始材料;这些案例依赖工具和执行环境,超出本页纯文本体验范围。
第三方评测:核对具体型号与设置
下表采用 2026 年 11 月 4 日核验的第三方榜单快照。Artificial Analysis 指数版本为 v5.0.1;链接中的 Agent Arena 快照标注 11 月 1 日。两处设置分别列明,旧 Terra 在 Arena 中采用 xHigh。
| 模型 | AA 智能指数 v5.0.1 | Agent Arena 综合排名 / 设置 | Arena 会话样本数 |
|---|---|---|---|
| GPT-6.1 Terra | 51 · Max | 8 / 57 · Max | 19,912 |
| GPT-5.6 Terra | 32 · Max | 32 / 57 · xHigh | 44,557 |
| Qwen 3.7 Plus | N/A | 45 / 57 · 未标注 | 24,493 |
| Kimi K3 | N/A | 25 / 57 · Max | 161,000 |
AA 使用固定评测集合;Arena 按 因果追踪方法 分析真实 Agent 会话中的多项信号。Arena 名次不是答题正确率,也不能与 AA 指数求平均。N/A 表示当前 AA 型号页未提供指数值,不代表零分;此处不拿旧版本指数补齐。
第三方数据说明 Terra 值得纳入升级评估,但不代表每项任务都胜出。公开 Max、xHigh 结果不能直接预测本页的短文本直接回答表现。可在 页内模型对比 中用同一输入,核对字段正确性、执行时间和实际 Credits。
QVeris 模型参数
这里列出 QVeris 当前接入型号的上下文长度、最大输出和支持的输入类型。
| 模型 | 上下文 token | 最大输出 token | 目录输入模态 |
|---|---|---|---|
| GPT-6.1 Terra | 1,050,000 | 128,000 | image、text |
| GPT-5.6 Terra | 1,050,000 | 128,000 | text、image |
| Qwen 3.7 Plus | 1,000,000 | 65,536 | text、image |
| Kimi K3 (Agent Plan primary) | 1,048,576 | 131,072 | text |
价格对比与透明用量算式
| 模型 | 输入阶梯起点 | 输入 Credits / 百万 | 输出 Credits / 百万 | 缓存读取 Credits / 百万 |
|---|---|---|---|---|
| GPT-6.1 Terra | 0+ | 650 | 3,250 | 32.5 |
| GPT-6.1 Terra | 272,000+ | 1,300 | 4,875 | 65 |
| GPT-5.6 Terra | 0+ | 1,300 | 7,800 | 130 |
| Qwen 3.7 Plus | 0+ | 208 | 832 | 41.6 |
| Qwen 3.7 Plus | 256,001+ | 624 | 2,496 | 124.8 |
| Kimi K3 (Agent Plan primary) | 0+ | 1,805.5556 | 9,027.7778 | 180.5556 |
以上为 2026-11-02 核验的测试站 Credits 目录口径,不是厂商美元价格,也不作为正式站价格承诺。缓存命中使用缓存读取单价;长输入以适用阶梯计费,不能将基础价直接套到全部请求。
同样的 1,000 输入 + 200 输出 token,无缓存、基础阶梯下:Terra = (1,000 × 650 + 200 × 3,250) ÷ 1,000,000 = 1.30 Credits;GPT-5.6 Terra 为 2.86;Qwen 3.7 Plus 为 0.3744;Kimi K3 约 3.6111。Terra 在这个用量假设下比 GPT-5.6 Terra 低约 54.5%,但高于 Qwen。实际回答长度不同,最终费用也会不同。
OpenAI 标准美元价为每百万输入 $1、输出 $5、缓存读取 $0.05;超过 272K 输入时采用长上下文价格。当前 OpenRouter 渠道的价格覆盖规则从输入 272,000 起生效,与厂商文档的边界措辞不同;本页短文本体验不触及该阶梯。
模型对比结果
从 X 用户的 Terra 实测任务出发,选择两款模型,编辑问题后同题发送。点击“换一题”可轮换动画、视觉编程和拆除模拟的简化试用题。下方以列表展示作者实测对比,点击“查看”前往对应账号;本轮回答单独展示。
正在加载页内双模型体验;如果未显示,请刷新页面。
模型实测对比
先看任务,再看不同模型交付了什么、差距在哪里。这里分开展示官方评测和 5 组社区实测;这是精选样本,不代表 X 上只有这些测试。
命令行编程任务完成率
提升 28.8 个百分点
公布的最高推理档成绩;越高越好。
事实错误率
下降 36.9 个百分点
内部易错提示词测试,low 档;越低越好。
Agents’ Last Exam 包含「建筑图纸 → 3D 模型」和「影片 → 带时间码的修复日志」。medium 档较 GPT-5.6 Terra 高 15 个百分点,成本约为三分之一。这些是带工具的智能体工作流,与上方文本试用不同。
核心能力与对应实测
视觉理解 → 执行任务
Agents’ Last Exam 在 medium 档较 5.6 Terra 提升 15 个百分点,成本约为三分之一。官方案例包含工具操作;下方社区案例没有独立复现这组计算机操作评测。
编程增强 → 要看推理档位
官方最高推理档完成率从 21.5% 提升至 50.3%。社区 105 缺陷测试中,作者报告 max 分数为 32 → 40.7,但 xhigh 为 20 → 11.3。两项测试口径不同:最高档增强,不代表每个档位都能直接升级。 查看社区实测
效率优势 → 同时看成品质量
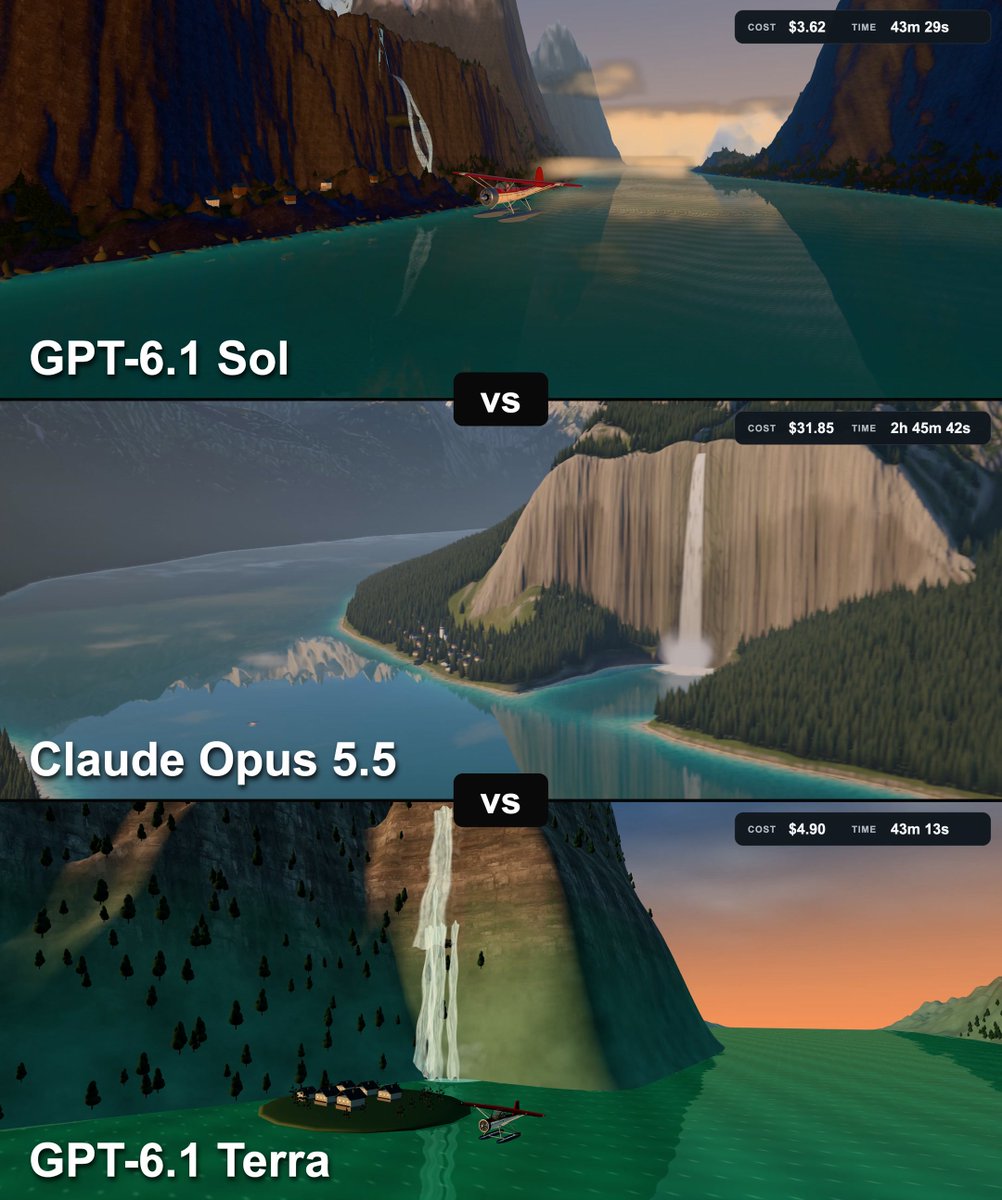
Alpine Gold 报告中,Terra 为 $4.90 / 43 分钟,Opus 为 $31.85 / 2 小时 45 分钟;Sol 为 $3.62 / 43 分钟。庭院测试中,Terra 为 $1.23,Opus 为 $14.17,但作者更认可 Opus 的视觉表现。低成本需要结合成品质量判断。 查看社区实测
社区实测:同一任务,具体差别
| 任务 / 输入 | GPT-6.1 Terra 结果 | 对照结果 | 差异与判断 | 查看 |
|---|---|---|---|---|
| 像素风庭院乒乓球 单 HTML,包含物理与人物运动的 3D 场景。 | $1.23;作者认为颜色偏淡、人物运动不自然。 | Opus 5.5:$14.17;作者更认可光照、色彩与细节。 | Terra 报告费用约低 91%,但视觉偏好投给 Opus;通过演示查看实际画面。 | 结果 / 演示 @vib3coded |
| Alpine Gold 场景 三个模型使用同一场景提示词。 | $4.90 · 43 分钟 | Sol:$3.62 · 43 分钟;Opus 5.5:$31.85 · 2 小时 45 分钟。 | 较 Opus 费用约低 85%;Sol 比 Terra 更便宜。作者仍更认可 Opus 的反射和森林细节。 | 结果 / 演示 @EnvolDev |
| 查找并修复植入缺陷 2 个仓库、105 个植入缺陷。 | max:40.7;xhigh:11.3;high:9.7。 | GPT-5.6 Terra:max 32;xhigh 20;high 18。 | 按作者报告的分数,max 高 8.7,但较低推理档退步;原帖未充分解释分数单位与完整评分规则。 | 结果 / 演示 @PawelHuryn |
| 3D 房屋拆除 同题生成 3D 拆除模拟。 | 7.5/10 · 6分20秒 · $0.24 | Muse Spark 1.3:8.7/10 · 6分31秒 · $0.16;DeepSeek V4.1 Flash:6.3/10 · 10分49秒 · $0.06。 | Terra 比 Muse 快 11 秒;Muse 作者评分高 1.2,费用低 $0.08。不是统一基准成绩。 | 结果 / 演示 @LatentOperatorX |
| 鹈鹕骑车动画 生成鹈鹕骑自行车的动画。 | 脚部动作未达预期。 | 该帖没有其他模型的同题输出。 | 失败案例:重点看脚、踏板、车轮是否同步运动,不能据此排模型名次。 | 结果 / 演示 @xmglab |
以上美元费用、耗时、分数与视觉判断来自原作者报告,不是 QVeris 结算或本站复跑成绩。链接分别打开实际结果和作者账号;没有原始对照的案例不补造“前后效果图”。
使用说明与常见问题
如何比较两侧回答?
本轮对比展示实际耗时、平均吞吐速度、输入与输出 token、响应型号和已结算 Credits。X 案例改写的创作题需要人工验收,不自动生成准确率评分;下方原作者的报告与用户当前运行结果分别展示。
为什么某侧失败,另一侧还有回答?
两次请求分别执行。余额、模型可用性、输出上限和上游错误都可能影响单侧结果;页面保留成功与部分返回内容,不自动重试,不把请求失败评为能力零分。
能比较图片或执行工具吗?
这版只比较文本问答。目录中的视觉标签说明模型输入能力,不代表本页已实现图片上传;工具调用和超长上下文另行验证。
官方来源与相关阅读
- OpenAI:GPT-6.1 Terra 发布与评测
- OpenAI:GPT-5.6 系列定位
- Qwen:Plus 精确型号说明
- Moonshot:Kimi K3 技术发布与案例
- Artificial Analysis:Terra Max 与 v5.0.1 指数
- Artificial Analysis:上一代 Terra Max
- Artificial Analysis:Qwen3.7 Plus
- Artificial Analysis:Kimi K3 Max
- Arena:Agent 榜单快照
- Arena:评测方法
- OpenAI Terra 官方规格与价格
- OpenRouter 精确型号与渠道资料
- QVeris Terra 详情
继续阅读:Gemini 4 Carbon · Kimi K3.1 Pro · 全部模型。