
回答将在这里生成
选择模型,在下方发送同一个问题。回答将在这里生成
选择模型,在下方发送同一个问题。模型对比
模型能力定位
下列试用任务是编辑建议。规格与价格使用 11 月 11 日 QVeris 公开目录快照,评测数据保留原始设置。
| 模型 | 官方能力与依据 | 建议先试的任务 | 使用边界 |
|---|---|---|---|
| Claude Fable 5.2 | 高难度推理与长任务。文档 | 检查复杂 SQL 关联,或把迁移拆成可验收步骤。 | 思考始终开启;本页不提供执行工具。 |
| Gemini 4 Carbon | Google 11 月 10 日公开开放的最新前沿型号,面向长任务编程、研究与知识工作。官方发布 | 审查多步骤排错方案,或核对结构化财务表格。 | 官方智能体演示含工具与反复验证;页内体验仅支持文字。 |
| GPT-6.1 Sol | OpenAI 定位于复杂编程、计算机操作与专业工作。文档 | 审查同一 SQL 聚合逻辑,或实现一个可测试的小功能。 | 原生工具调用需使用 Responses API;文字回答不等于已执行完整任务。 |
| Kimi K3.1 Pro | Moonshot 发布资料覆盖编程、3D 创作和金融研究。技术文章 | 试中文资料整合或参数化建模方案。 | 此处是 Pro,非 Highspeed;工具演示需要相应运行环境。 |
QVeris 模型参数
| 模型 | 上下文 token | 最大输出 token | 目录输入 |
|---|---|---|---|
| Claude Fable 5.2 | 1,000,000 | 128,000 | file, image, text |
| Gemini 4 Carbon | 1,048,576 | 943,718 | image, text |
| GPT-6.1 Sol | 1,050,000 | 128,000 | image, text |
| Kimi K3.1 Pro | 1,048,576 | 1,048,576 | image, text |
目录上限是服务配置,不保证输入与输出上限可同时用满;文章输入框未开放文件上传。
价格对比与透明用量算式
| 模型 | 输入阶梯起点 | 输入 Credits / 百万 | 输出 Credits / 百万 | 缓存读取 Credits / 百万 |
|---|---|---|---|---|
| Claude Fable 5.2 | 0+ | 4,200 | 21,000 | 105 |
| Gemini 4 Carbon | 0+ | 1,050 | 5,250 | 52.5 |
| GPT-6.1 Sol | 0+ | 1,050 | 5,250 | 52.5 |
| GPT-6.1 Sol | 272000+ | 2,100 | 7,875 | 105 |
| Kimi K3.1 Pro | 0+ | 1,015.9275 | 5,314.1025 | 101.5875 |
2026 年 11 月 11 日核对的 QVeris 公开价格。表格保留全部公开 token 价格阶梯;GPT-6.1 Sol 从 272,000 输入 token 起进入第二阶梯,未列独立请求费。公开目录未提供缓存写入价,使用前需核对具体计费。实时目录
假设 1,000 个无缓存输入 token、200 个输出 token:费用 =(输入 token × 输入单价 + 输出 token × 输出单价)÷ 1,000,000。Fable 5.2 为 8.40 Credits;Gemini 4 Carbon 为 2.10;GPT-6.1 Sol 为 2.10;Kimi K3.1 Pro 约 2.079。此为固定用量算例,不是实付账单;思考与更长输出会改变用量。
Anthropic 标准美元价(每百万 token):输入 $8、输出 $40、缓存读取 $0.20;缓存写入 $10(5 分钟)/ $16(1 小时)。Fast mode 单独计价为 $16 / $80。厂商美元价与 Credits 分开,本页不据此宣称 QVeris 已开放快速模式。官方价格
模型优势与官方评测
Claude Fable 5.2 于 2026 年 11 月 9 日发布,面向高难度推理和长时间智能体任务。Anthropic 建议日常工作先从 Opus 5.5 开始,再按任务难度考虑 Fable。官方发布
QVeris 已上架精确型号 claude-fable-5-2。公开目录标注文本、图片和文件输入、文本输出。页内体验只接收文字,不执行代码或操作浏览器。
原生规格为 100 万 token 上下文、128K 输出上限,自适应思考始终开启,原生 API 默认 high。页内短回答不能等同于持续数小时的智能体执行。型号文档
从原始发布材料看具体差异
| 评测 | Fable 5.1 | Fable 5.2 | 差异 / 设置 |
|---|---|---|---|
| FrontierCode 2.0 | 32.4% | 49.1% | +16.7 个百分点 · Xhigh 档位 |
| FrontierSWE v2 | 56.3% | 69.9% | +13.6 个百分点 · 按原文采用最高可用档位 |
| Chartography · no tools | 44.8% | 73.4% | +28.6 个百分点 · 无工具;图表识别 |
以上厂商测试均为越高越好;不能视为通用胜率,也不能直接预测本页短回答效果。
官网机器人能力评测:RoboDojo Sim
RoboDojo Sim 测试模型能否根据摄像头图像控制模拟双臂机器人,考察视觉理解与动作控制的结合。Anthropic 在同一评测框架下,使用各模型最高可用思考档位进行内部测试。
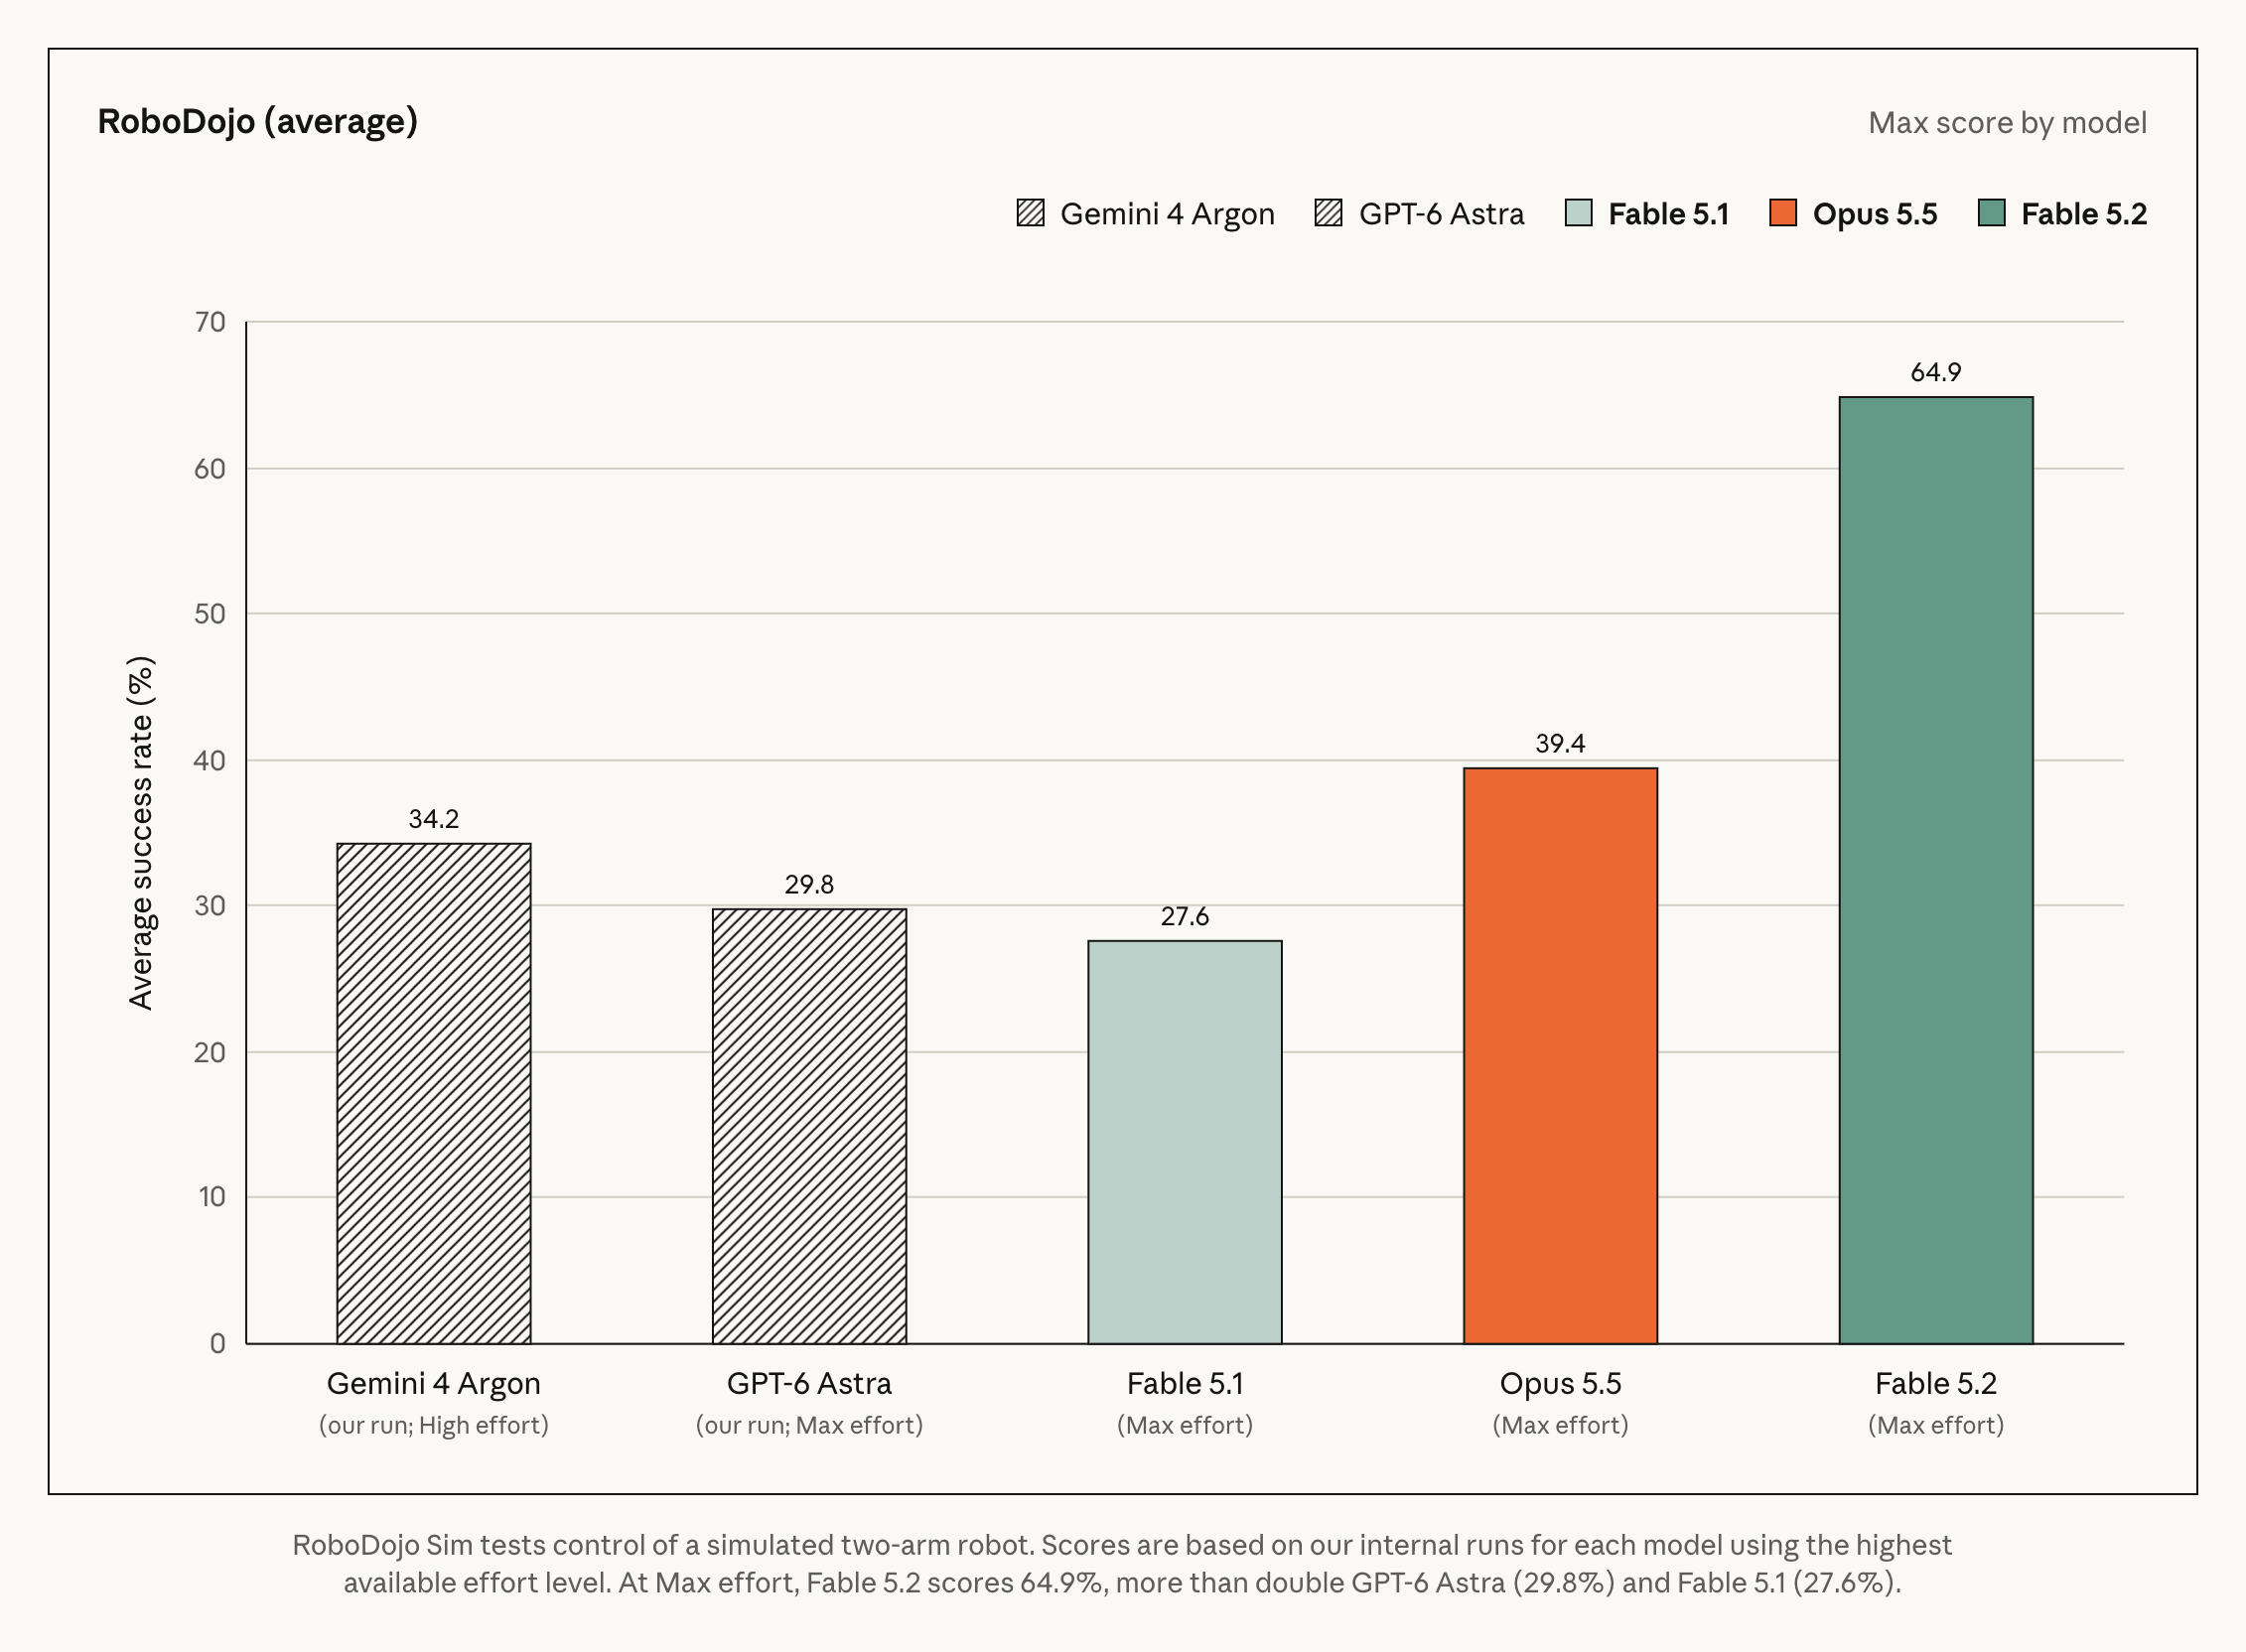
RoboDojo 平均成功率(%)· 各模型最高得分。来源:Anthropic 官方发布。点击图片查看完整原图。
Fable 5.2 平均成功率为 64.9%;Opus 5.5 为 39.4%,Gemini 4 Argon 为 34.2%,GPT-6 Astra 为 29.8%,Fable 5.1 为 27.6%。Fable 5.2 比 Opus 5.5 高 25.5 个百分点,比 Fable 5.1 高 37.3 个百分点。
图中 Gemini 4 Argon 使用 High 档位,其余四款模型使用 Max。以上为厂商公布的模拟环境测试结果,不是 QVeris 复跑成绩或现实机器人任务的通用成功率;图中的 Argon、Astra 与上方对比区的 Carbon、Sol 是不同型号。
第三方评测:能力与成本一起看
| 来源 / 设置 | 公布结果 | 如何解读 |
|---|---|---|
| Artificial Analysis · v5.0.1 · Max / Default Fallback | 指数 65;每项指数任务 $26.54、44.4 分钟。 | 九项评测聚合指数,不是 65% 正确率;该费用不是 QVeris 结算。摘要未给出样本总量。 |
| Ultralytics · UL37 v2 | 36 个数据集、360 张图;Fable 5.2 mAP50 为 0.544,5.1 为 0.427。 | 默认思考档位、实际标注流程及 SAM 3.1 优化;与纯文本推理评测不同。 |
真实实测:官网案例与 X 用户
以下为原作者报告的实测,资料核验于 11 月 11 日。官方客户案例、独立评测与 X 演示分开标注;美元估算不等于 QVeris 账单。
官网客户实测:SQL 业务正确性
Oracle 的 Liyu Gong 测试了关联国家债务汇总、偿还记录与区域基准的查询,重点比较 SQL 运行后能否给出正确的业务总额。
| 对比维度 | Claude Fable 5.2 | 另外两款未具名模型 |
|---|---|---|
| SQL 执行 | 返回结果 | 均可成功运行 |
| 业务总额 | 符合预期结果 | 总额放大至预期的 5–8 倍 |
| 客户报告结论 | 本次任务的业务结果正确 | 可运行,但业务结果错误 |
原文未公开完整提示词、对照型号及样本量;这是一项客户任务的结果,不代表通用成功率排名。查看客户原始说明
社区实测:看具体作品与取舍
| 任务 / 输入 | Fable 5.2 结果 | 对照结果 | 差异与判断 | 查看 |
|---|---|---|---|---|
| 体素动画片段重建 | Fable 5.2 Extra:29 分钟;API 等价成本 $56.89。 | GPT-6.1 Sol xhigh:3 小时 26 分钟;$12.02。 | 使用同一参考视频;更快但成本约 4.7 倍。仍有标题贴边和场景边界露出,无客观评分。 | 结果 / 演示 @thehypedotnews 测试报告 |
| Three.js 怪物卧室 | 首轮:1 小时 32 分钟;API 等价成本 $27.50。 | Fable 5.1:1 小时 14 分钟;$28.03。 | 房间要求相同、怪物要求不同。5.2 此例更慢,手臂姿态仍不自然;输入并非完全一致。 | 结果 / 演示 @thehypedotnews |
| 3D 水上飞机 · Claude Code | Low:Lumina 3D 指数 1,100;High:1,115。X 视频展示 Low。 | 作者指数中 Opus 5.5 xHigh 为 1,097。 | 作者更认可飞机、水面与控件的一致性。档位不同,指数分数不是成功率。 | 结果 / 演示 @LuminaBench 测试报告 |
| 安检 X 光标注 · 10 张图 | Fable 5.2 拒绝全部 10 张。 | Fable 5.1 拒绝 1 张;Opus 5.5 回答全部 10 张。 | Ultralytics 使用原生 API 复核。这是该数据集的可用性失败,不等于通用视觉能力为零。 | 结果 / 演示 Glenn Jocher 测试报告 |
这些案例适合帮助确定验收项:SQL 看业务总额,智能体任务看耗时和费用,3D 输出看具体缺陷,图片流程看拒绝处理。并非每个案例都公开了完整原始提示词。
使用说明与常见问题
选择两款模型,同题发送文字。内置 5 项完整交付任务:带校验的 SQL 脚本、异步搜索修复与回归测试、可交互的 3D 水上飞机、可审计财务报告、可播放卧室短片。每题包含输入和验收要求;生成的代码或报告需实际运行或审阅,本页不自动判定其正确性。对下方创作案例,可在这里比较方案与代码解释,再在独立执行环境验收完整项目。
如何使用 Agent 对比提示词
点击顶部“让Agent比较模型”,将提示词粘贴给你的 Agent。内含可执行 SQL 数据集、可选 3D 任务、来源链接、验收项与费用报告要求。复制无需登录,也不会发送模型请求。测试题是编辑改编,并非客户未公开的原始提示词。
Fable 一定比 Opus 好吗?
不一定,应匹配任务、思考档位和预算。token 单价不能单独预测完成任务的成本。
如何判断页内体验结果?
先验正确性,再看速度。每侧最多 3,072 输出 token,无执行工具,不能复现 X 原帖完整项目。
为什么单侧会失败?
可用性、预算、输出上限和上游错误都可能不同。保留部分输出;型号未核验或未完整返回不能算零分。
原生 API 接入要注意什么?
自适应思考不能关闭;省略 temperature、top_p、top_k,不支持强制工具选择 any/tool。原生文档另规定 30 天数据保留,除非获得明确例外授权。